اپل با MLX یک مدل ۸۱۶ میلیارد پارامتری را روی چهار Mac Studio اجرا کرد
اپل نشان داد با نسخهی جدید MLX و RDMA روی Thunderbolt 5، کلاستری از چهار Mac Studio با M5 Ultra مدل Muse Spark Open را با بیش از ۳۶ توکن در ثانیه اجرا میکند؛ بهعلاوهی agentic coding کاملاً محلی با OpenCode.
17 Oct 2026 · 4 min read · Apple · MLX · Mac Studio · M5 Ultra · LLM · local AI · distributed inference · OpenCode
تیم تحقیقات یادگیری ماشین اپل در پست تازهای نشان داده که با نسخهی جدید MLX میشود مدل Muse Spark Open را، با ۸۱۶ میلیارد پارامتر، روی میز کار خودتان اجرا کرد: یک کلاستر از چهار Mac Studio با تراشهی M5 Ultra که با کابل Thunderbolt 5 به هم وصل شدهاند، این مدل را با سرعت بیش از ۳۶ توکن در ثانیه اجرا میکند؛ یعنی سریعتر از سرعت خواندن یک آدم معمولی.
روی یک Mac Studio چه خبر است؟
اپل سه مدل را بنچمارک کرده: Muse Spark Open (معماری MoE با ۸۱۶ میلیارد پارامتر کل و ۴۲ میلیارد پارامتر فعال، با دقت NVFP4)، Mistral Medium 3.5 (۱۲۸ میلیارد، FP8) و Qwen 3.8 (۲۷ میلیارد، BF16). دو مدل کوچکتر راحت روی یک Mac Studio با ۵۱۲ گیگابایت حافظهی یکپارچه جا میشوند؛ حتی با context ۶۵ هزار توکنی حداکثر ۶۸ و ۱۵۸ گیگابایت رم میگیرند.
- زمان رسیدن اولین توکن (TTFT): این بخش محاسبهمحور است و Neural Acceleratorهای GPU در M5 Ultra باعث شدهاند تا ۴.۶ برابر سریعتر از M3 Ultra باشد.
- سرعت تولید متن: این بخش به پهنای باند حافظه وابسته است. M5 Ultra پهنای باند ۱.۲ ترابایت بر ثانیه دارد (در برابر ۸۱۹ گیگابایت بر ثانیه در M3 Ultra) و حدود ۱.۶ برابر توکن بیشتری در ثانیه تولید میکند.
- مصرف برق: اوج مصرف حدود ۳۰۰ وات برای M5 Ultra و ۲۰۰ وات برای M3 Ultra است؛ کمتر از یک توستر.
مدلی که روی یک دستگاه جا نمیشود
Muse Spark Open در دقت اصلی خودش (BF16) فقط برای پارامترها بیش از ۱.۶ ترابایت رم لازم دارد. نسخهی ۴ بیتی NVFP4 این عدد را به حدود ۴۹۳ گیگابایت میرساند، ولی با حافظهی لازم برای محاسبات میانی باز هم روی یک دستگاه جا نمیشود. راهحل اپل دو روش موازیسازی است:
- Pipeline parallelism: نیمی از لایهها روی یک Mac و نیم دیگر روی Mac دوم. پیادهسازیاش ساده است و سرعت تولید تقریباً مثل یک دستگاه میماند، ولی برای context خیلی بزرگ، prefill تا حدود ۱.۸ برابر سریعتر میشود چون MLX ورودی را تکهتکه میکند و دو دستگاه همزمان کار میکنند.
- Tensor parallelism: هر لایه بین چند دستگاه تقسیم میشود. پیچیدهتر است و ارتباطات زیادی لازم دارد، برای همین بدون درایور RDMA روی Thunderbolt 5 (از macOS 26.2) و backend جدید jaccl در MLX (از نسخهی 0.30.1) عملاً فایدهای نداشت. با چهار M5 Ultra، Qwen 3.8 به حدود ۵۱ توکن در ثانیه و Mistral Medium 3.5 به حدود ۲۳ توکن در ثانیه میرسد.
جالب اینکه اپل هر جفت دستگاه را با دو کابل Thunderbolt به هم وصل کرده تا پهنای باند دو برابر شود؛ برای Muse Spark Open روی چهار دستگاه با context ۶۵ هزار توکنی، همین کابل دوم TTFT را از حدود ۵۰.۵ ثانیه به ۴۰.۶ ثانیه رسانده. همهی اینها هم با چند دستور ساده اجرا میشود:
mlx.launch --hostfile hostfile.json --backend jaccl --env MLX_METAL_FAST_SYNCH=1 -- \
  mlx_lm.benchmark --model meta-models/Muse-Spark-Open-816B-A42B-NVFP4 -p 8192 -g 128 -b 1
agentic coding کاملاً محلی
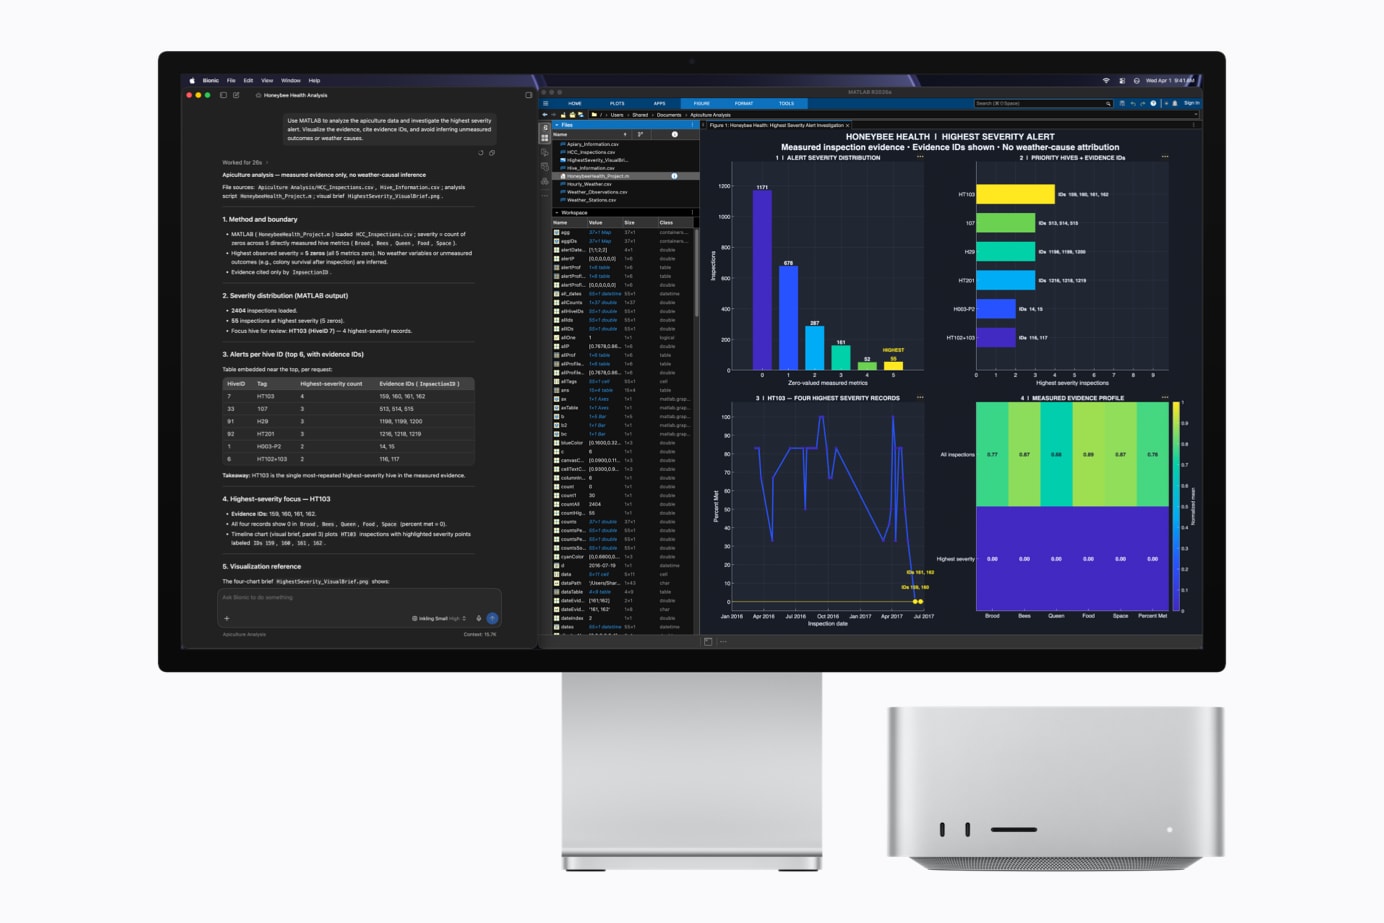
بخش آخر پست برای برنامهنویسها از همه جذابتر است: با mlx_lm.server یک سرور سازگار با API اوپنایآی بالا میآورید (میشود آن را هم با mlx.launch روی چند Mac پخش کرد) و بعد ابزاری مثل OpenCode را با یک فایل config ساده به همین مدل محلی وصل میکنید. یعنی یک دستیار کدنویسی با مدلی در حد frontier، بدون اینکه یک خط کد از شبکهی خودتان بیرون برود.
نظر من
این پست در ظاهر مقالهی تحقیقاتی است ولی در واقع بهترین تبلیغ ممکن برای Mac Studio است، و راستش تبلیغ قانعکنندهای هم هست. اینکه یک مدل ۸۰۰ میلیارد پارامتری روی چهار دستگاهی که روی میز جا میشوند و هر کدام حدود ۳۰۰ وات مصرف دارند با ۳۶ توکن در ثانیه اجرا شود، چند سال پیش فقط با رک سرور و GPUهای دیتاسنتری ممکن بود. حافظهی یکپارچهی اپل برای inference واقعاً مزیت جدی است.
ولی بیایید حسابوکتاب را هم ببینیم: Mac Studio با M5 Ultra از ۵,۴۹۹ دلار شروع میشود و نسخهی ۵۱۲ گیگابایتی خیلی گرانتر است؛ چهار تای آنها برای بیشتر آدمها و تیمهای کوچک «روی میز» نیست. نکتهی دیگر اینکه ۳۶ توکن در ثانیه با context هشتهزارتایی اندازهگیری شده؛ برای agentic coding که context صدها هزار توکنی دارد، TTFT چهلثانیهای در context ۶۵ هزار توکنی هنوز آزاردهنده است. با این حال برای شرکتهایی که نمیخواهند یا نمیتوانند کدشان را به API خارجی بفرستند (که برای ما در ایران با تحریم و قطعی دلیل کاملاً واقعی است)، مسیر «مدل بزرگ، کاملاً local» حالا خیلی جدیتر شده. اگر Mac با Apple silicon دارید، حتی با یک دستگاه و مدلهای کوچکتر مثل Qwen، MLX ارزش امتحان کردن دارد.
منبع: Apple Machine Learning Research · Apple Newsroom · بحث در Hacker News
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.