دیپسیک موتور استنتاج production خودش را متنباز کرد: DeepInfer
DeepSeek چارچوب DeepInfer را با لایسنس Apache 2.0 منتشر کرد؛ موتوری که سرویسهای خودش با آن اجرا میشوند، با کرنلهای بهینه، Expert Parallel و پشتیبانی از Blackwell و Huawei Ascend.
22 Oct 2026 · 2 min read · DeepSeek · DeepInfer · هوش مصنوعی · استنتاج LLM · متنباز · MoE · GPU
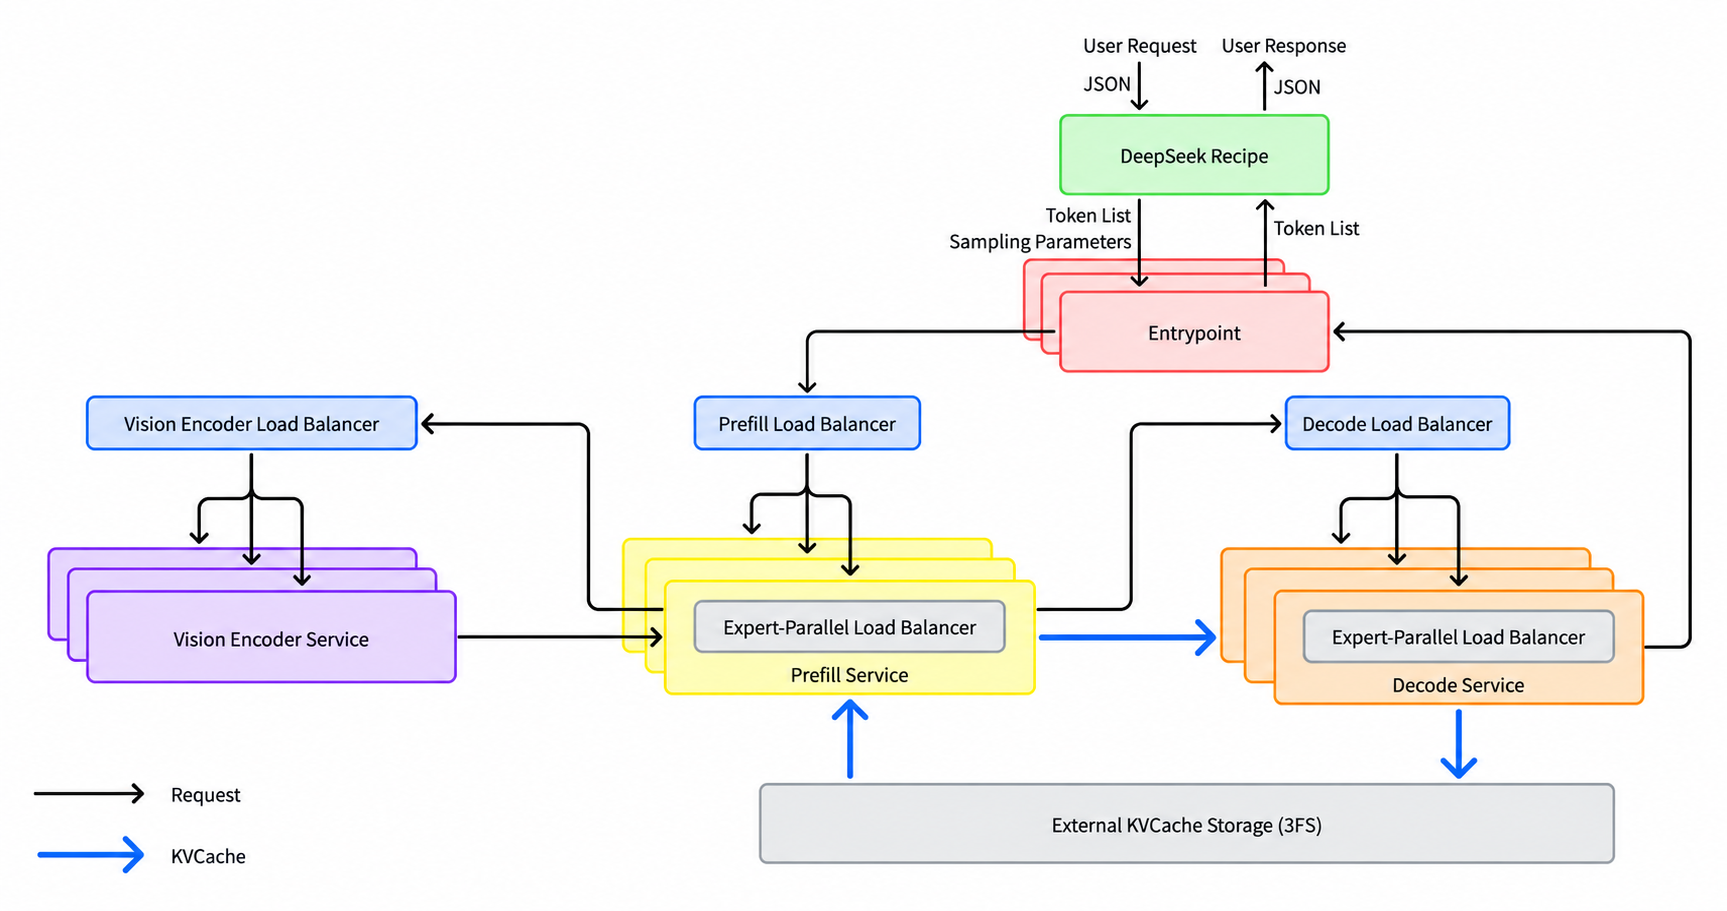
دیپسیک موتور استنتاجی را که سرویسهای production خودش روی آن اجرا میشود، با نام DeepInfer و لایسنس Apache 2.0 متنباز کرد. این پروژه در هکرنیوز بیش از ۲۳۰۰ امتیاز گرفت و مخزنش در چند روز نزدیک ۲۰ هزار ستاره خورده است. یعنی فقط مدل را منتشر نکردهاند، بخش مهمی از زیرساخت سرو کردنش را هم بیرون دادهاند.
چه چیزی منتشر شده؟
- مدل پشتیبانیشده: فعلاً فقط DeepSeek-V4.1-Flash.
- کرنلهای بهینه: FlashMLA، DeepGEMM، DeepEP، TileKernels، DeepSelect و کرنلهای TileLang.
- موازیسازی: Data Parallel برای Attention، Context Parallel متوازن، و Expert Parallel برای MoE همراه با EPLB.
- رمزگشایی سریعتر: DSpark با توکنهای پیشنویس (draft) و verification که بر اساس confidence زمانبندی میشود.
- زمانبندی ناهمگام: زمانبندی batch روی CPU همزمان با اجرای GPU انجام میشود.
- خروجی قطعی: batch-invariant inference و sampling قطعی (فقط روی NVIDIA)، بهعلاوهٔ structured output با Regex، JSON Schema و EBNF.
- سختافزار: GPUهای NVIDIA SM100 (نسل Blackwell) و NPUهای Huawei Ascend 950.
نکتهٔ مهم: این نسخه فقط استنتاج آفلاین را پوشش میدهد. سیستم KV Cache، جداسازی کامل Prefill و Decode و لودبالانسینگ بین replicaها در این انتشار نیست. پس هنوز یک سرویس کامل و آماده نیست؛ بیشتر موتور اصلی است. خود دیپسیک هم نوشته که DeepInfer در اصل روی vLLM ساخته شده و از SGLang و TensorRT-LLM هم الهام گرفته است.
اعداد بنچمارک
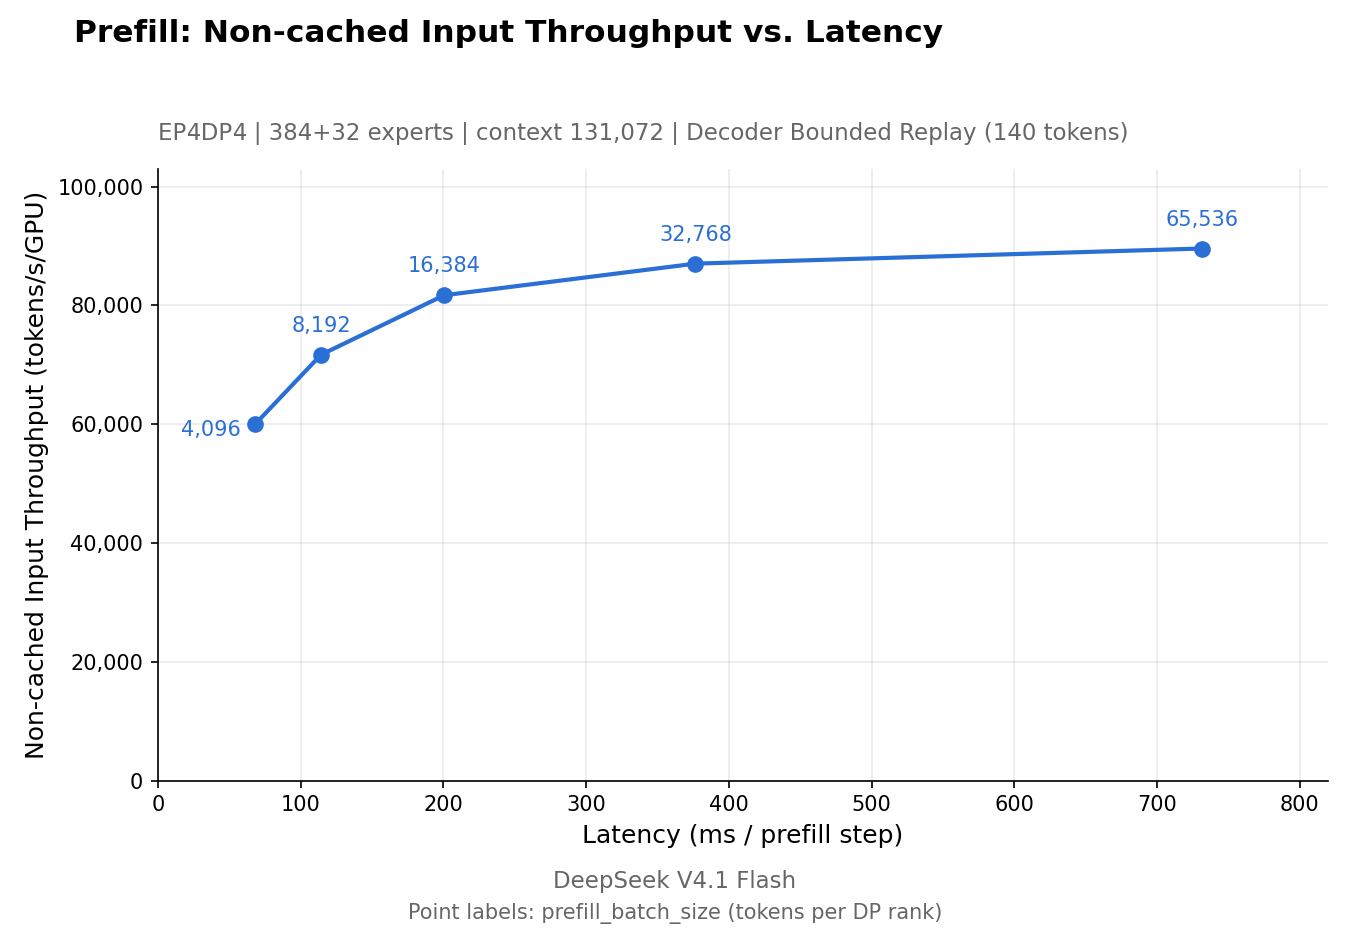
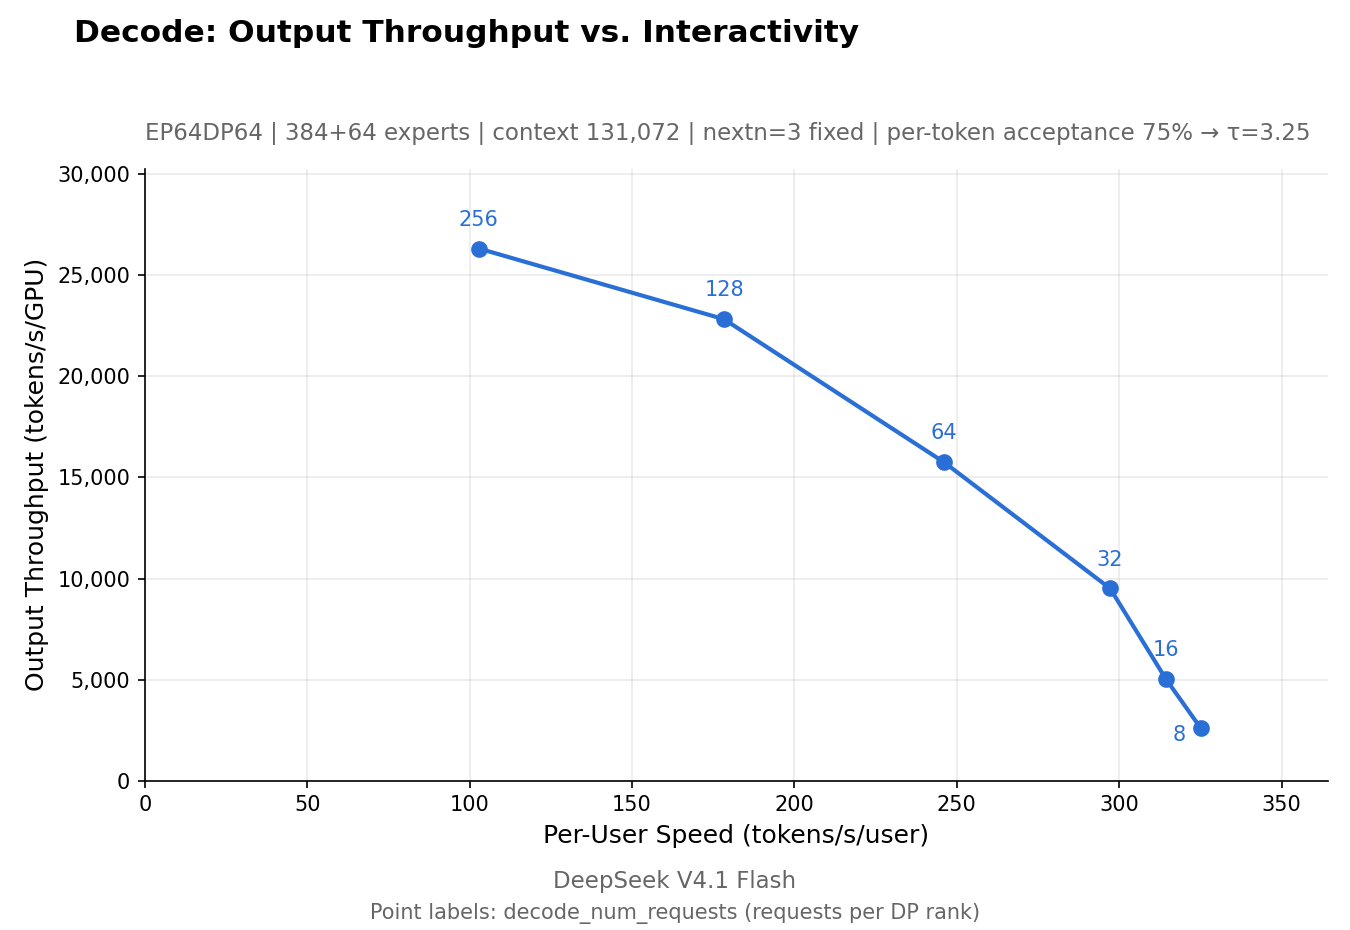
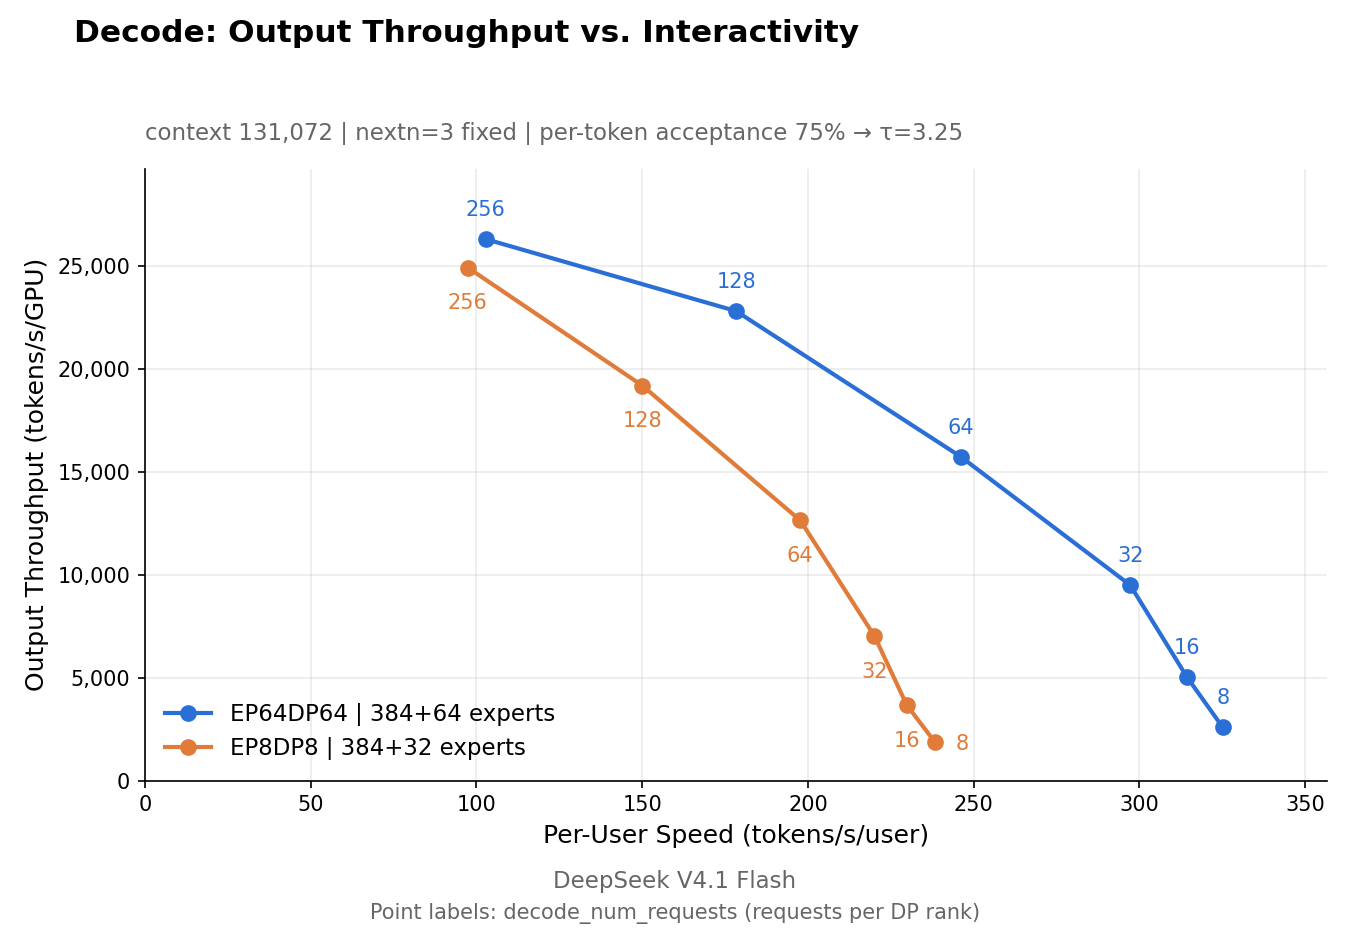
طبق نمودارهای خود مخزن، Prefill روی ۴ GPU با batchهای بزرگ به حدود ۹۰ هزار توکن ورودی در ثانیه به ازای هر GPU میرسد. در Decode روی ۶۴ GPU، حدود ۲۶ هزار توکن خروجی در ثانیه به ازای هر GPU به دست آمده؛ آن هم در حالی که هر کاربر حدود ۱۰۰ توکن در ثانیه میگیرد.
نظر من
به نظرم این از خود انتشار مدل مهمتر است. وزنهای باز وقتی واقعاً به درد میخورند که بشود آنها را ارزان و سریع سرو کرد، و دیپسیک حالا دقیقاً همان بخش سخت را باز کرده است. مقایسهٔ EP64 و EP8 هم خلاصهٔ کل داستان MoE است: هرچه expertها را روی GPUهای بیشتری پخش کنی، سود بیشتری میگیری.
البته واقعبین باشیم: SM100 و Ascend 950 سختافزار خانگی یا حتی استارتاپی نیستند. این پروژه بیشتر برای ارائهدهندههای بزرگ و تیمهای زیرساخت جذاب است تا کسی که میخواهد روی یک کارت گرافیک مدل اجرا کند. پشتیبانی رسمی از Ascend هم نشان میدهد دیپسیک جدی دنبال کم کردن وابستگی به انویدیاست. برای مهندسهای زیرساخت، کد این مخزن یک کلاس درس رایگان است.
منابع: مخزن DeepInfer در گیتهاب، بحث هکرنیوز
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.