چرا OpenAI و Anthropic در چند ماه قیمت مدلهایشان را تا ۸۰٪ کم کردند؟
از GPT-5.6 تا GPT-6.1 Sol و Opus 5.5، هزینهی LLMها تا ۸۰٪ سقوط کرده. تحلیل Max Woolf دربارهی نقش مدلهای open-weight، cache read و IPO، بههمراه نظر من.
26 Oct 2026 · 3 min read · هوش مصنوعی · LLM · OpenAI · Anthropic · قیمت API · مدلهای open-weight
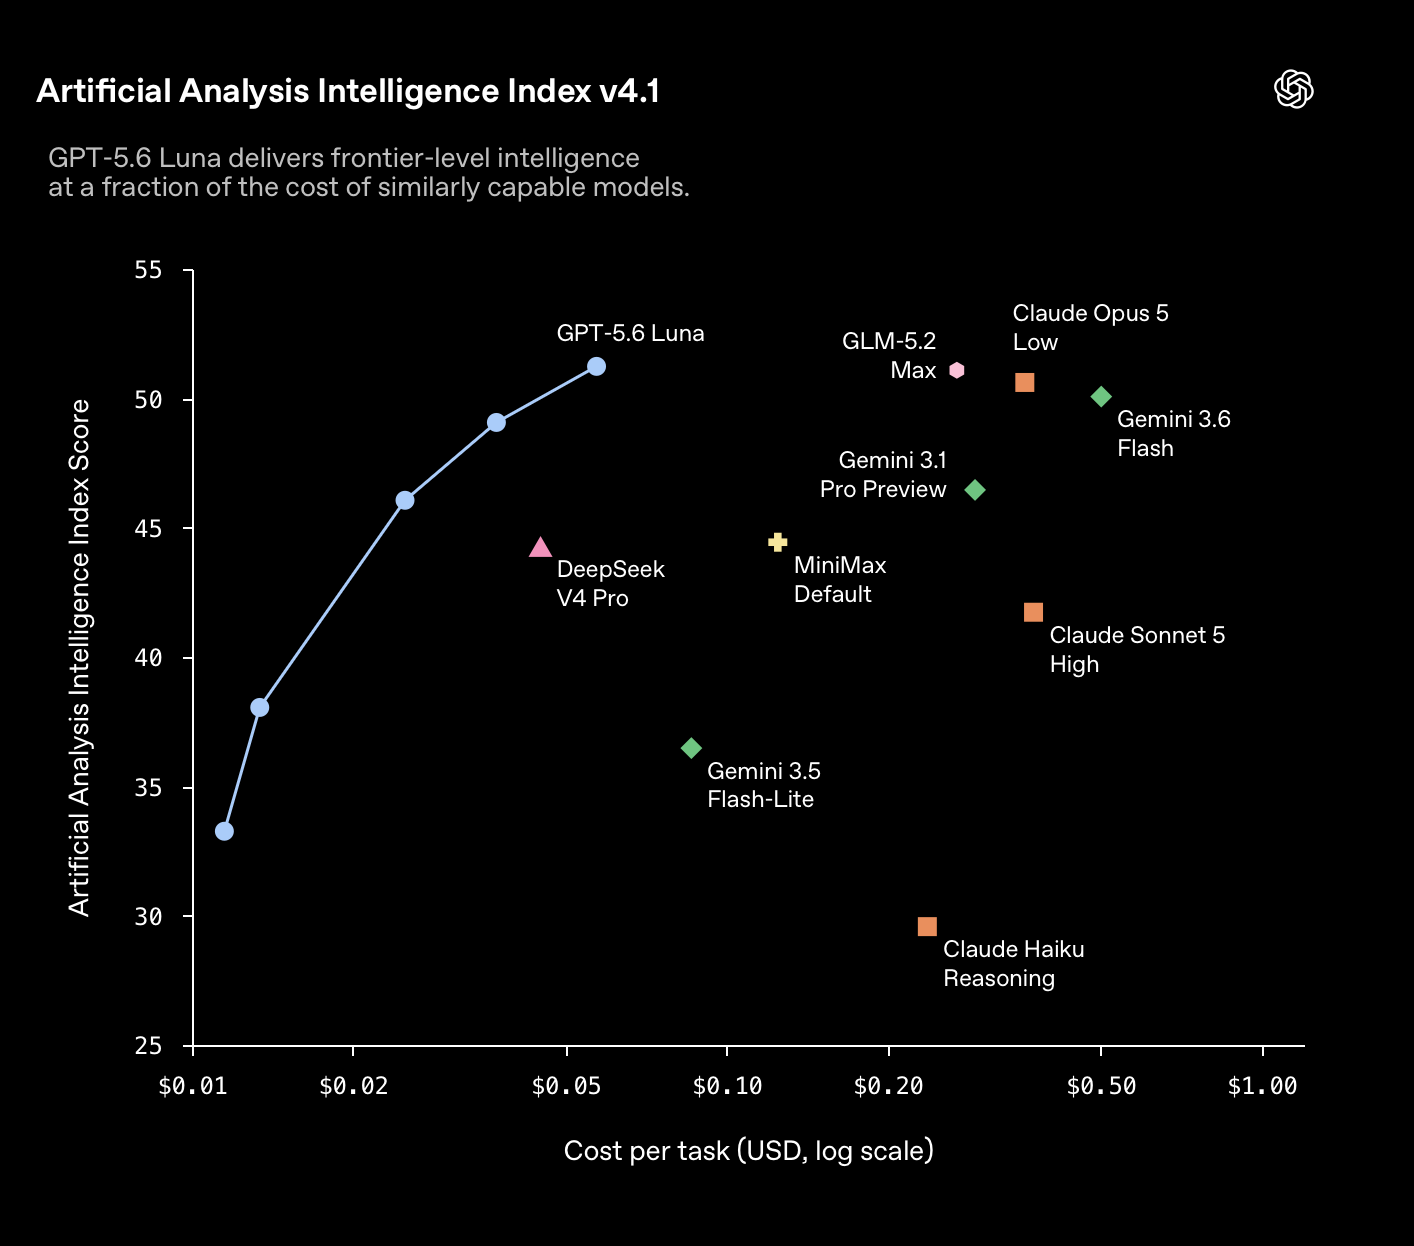
Max Woolf (همان minimaxir معروف) یک جمعبندی نوشته که حسابی در Hacker News سروصدا کرده: OpenAI و Anthropic فقط در چهار ماه گذشته قیمت مدلهایشان را تا ۸۰٪ پایین آوردهاند، آن هم بدون اینکه کیفیت خروجی افت کند. سؤال اصلیاش ساده است: چرا شرکتهایی که میلیاردها دلار ضرر میدهند و دم IPO هستند، درآمد اصلیشان را اینطور میبُرند؟
خط زمانی ارزانی
قیمتها بهصورت ورودی / خروجی / cache read برای هر میلیون توکن است:
- ژوئن: GPT-5.6 Sol با ۵ / ۳۰ / ۰٫۵ دلار و Luna با ۱ / ۶ / ۰٫۱ دلار آمد. Claude Sonnet 5 هم با قیمت «موقت» ۲ / ۱۰ دلار.
- ژوئیه: OpenAI قیمت GPT-5.6 Luna را یکباره ۸۰٪ کم کرد و رساند به ۰٫۲ / ۱٫۲ دلار.
- اوت: قیمت موقت Sonnet 5 دائمی شد و Sol حدود ۲۰٪ ارزانتر شد.
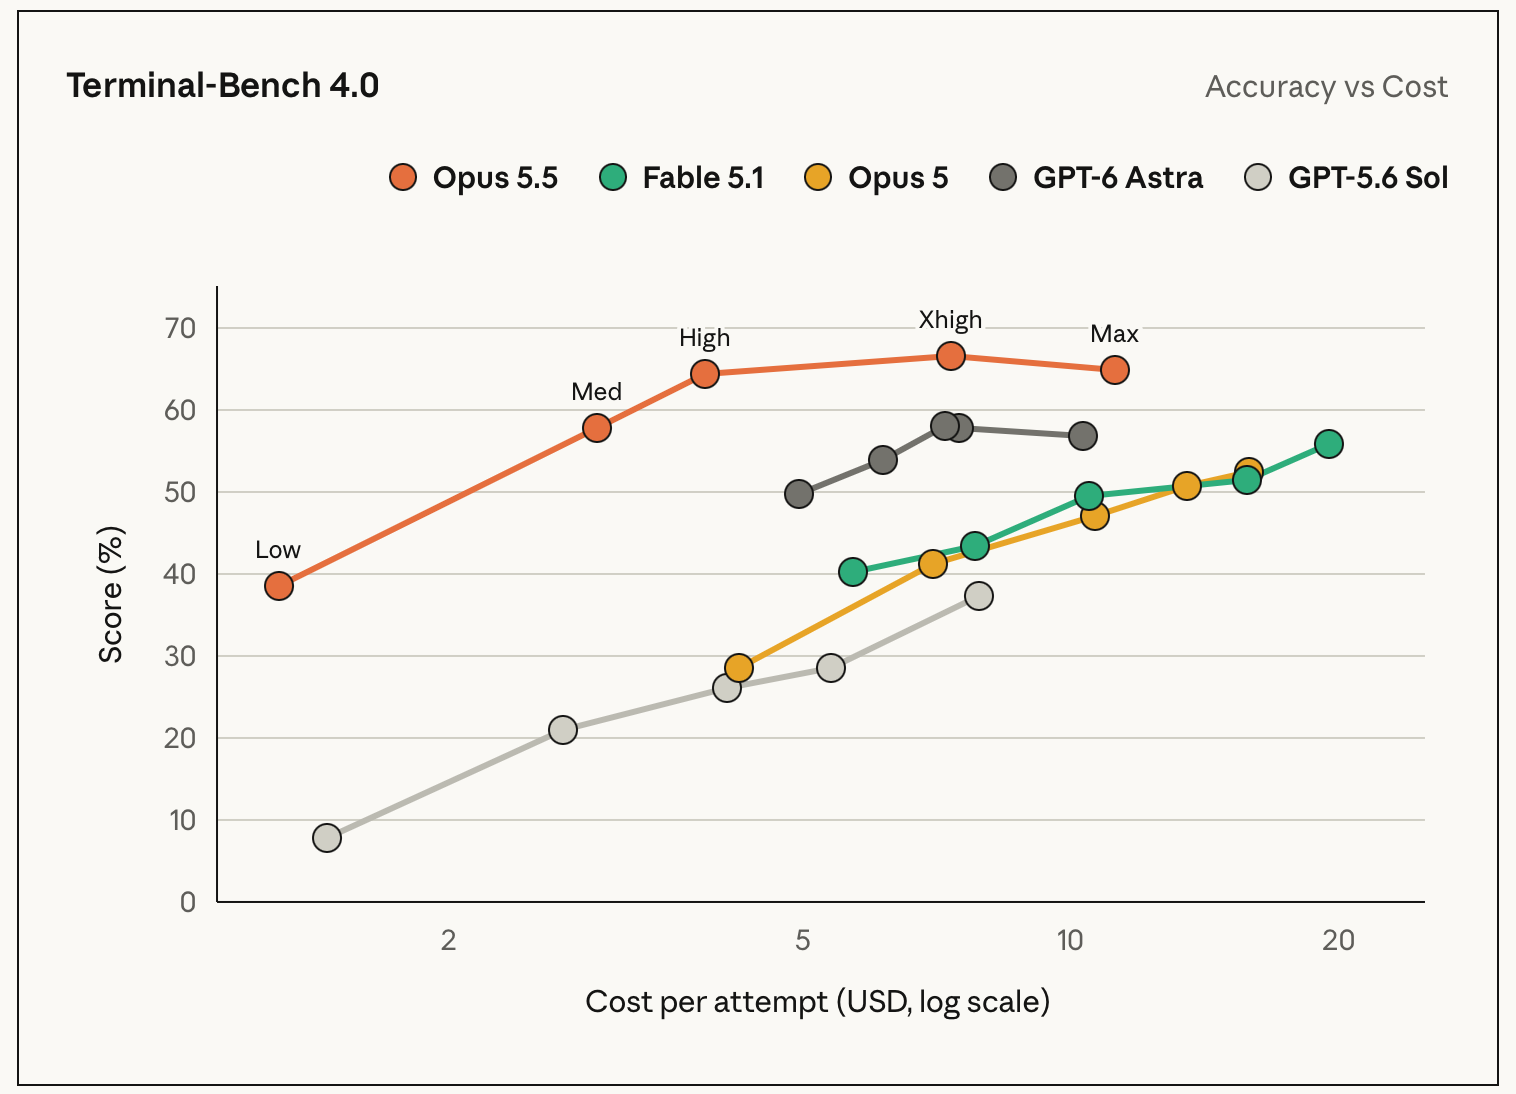
- سپتامبر: Claude Fable 5.1 هزینهی cache read را ۷۵٪ کم کرد؛ GPT-6 Sol با نصف قیمت نسل قبل آمد و همان روز Anthropic مدل Opus 5.5 را با کاهش کلی ۴۰ تا ۶۰ درصدی معرفی کرد.
- آخر سپتامبر: GPT-6.1 Sol با کیفیتی همسطح Astra و نصف هزینهی cache آمد؛ یعنی در مجموع حدود ۷۵٪ ارزانتر.
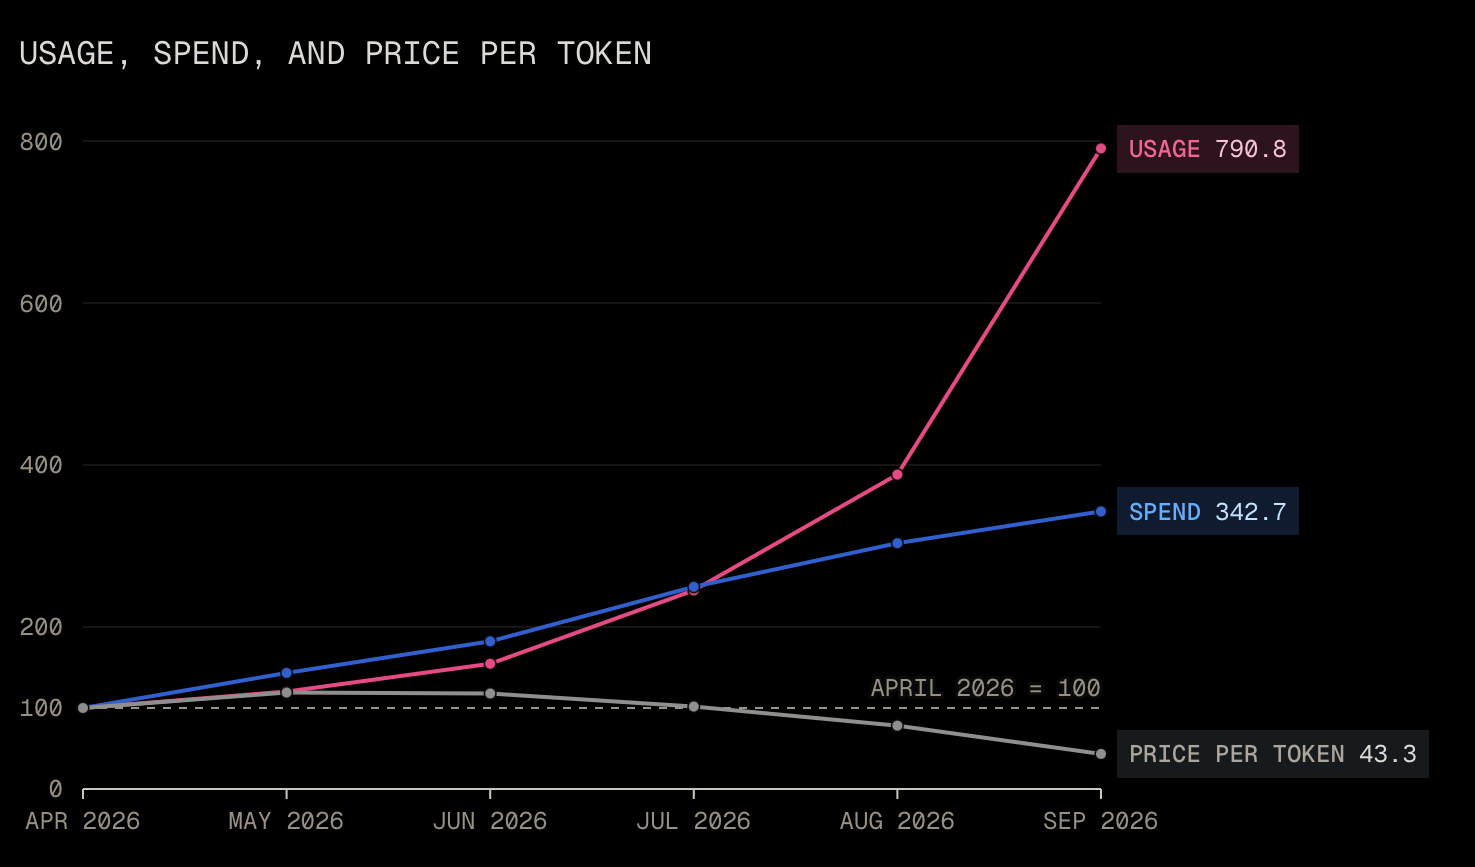
نکتهای که همه ازش رد میشوند: cache read
در کار با ایجنتهای برنامهنویسی، ۹۶ تا ۹۹ درصد توکنها cache read هستند، چون کل گفتوگوی قبلی در هر نوبت دوباره خوانده میشود. پس وقتی Anthropic هزینهی cache را ۷۵٪ کم میکند، عملاً هزینهی واقعی استفاده از مدل ۷۰ تا ۷۵ درصد پایین میآید، حتی اگر قیمت روی کاغذ تکان نخورده باشد.
چرا؟ رقابت با مدلهای open-weight
به نظر Woolf، مقصر اصلی مدلهای باز و ارائهدهندههای inference هستند. DeepSeek V4.1 Flash الان روی OpenRouter از ۲۹ ارائهدهندهی مختلف در دسترس است (در ماه مه ۱۳ تا بود) و قیمتش حدود ۰٫۱۵ / ۰٫۶ دلار است. وقتی عوضکردن مدل در OpenCode یا Zed فقط یک کلید است، moat عملاً وجود ندارد. Kimi K3.1 Pro هم با کیفیتی نزدیک به Opus 5.5 و نصف قیمتش در راه است.
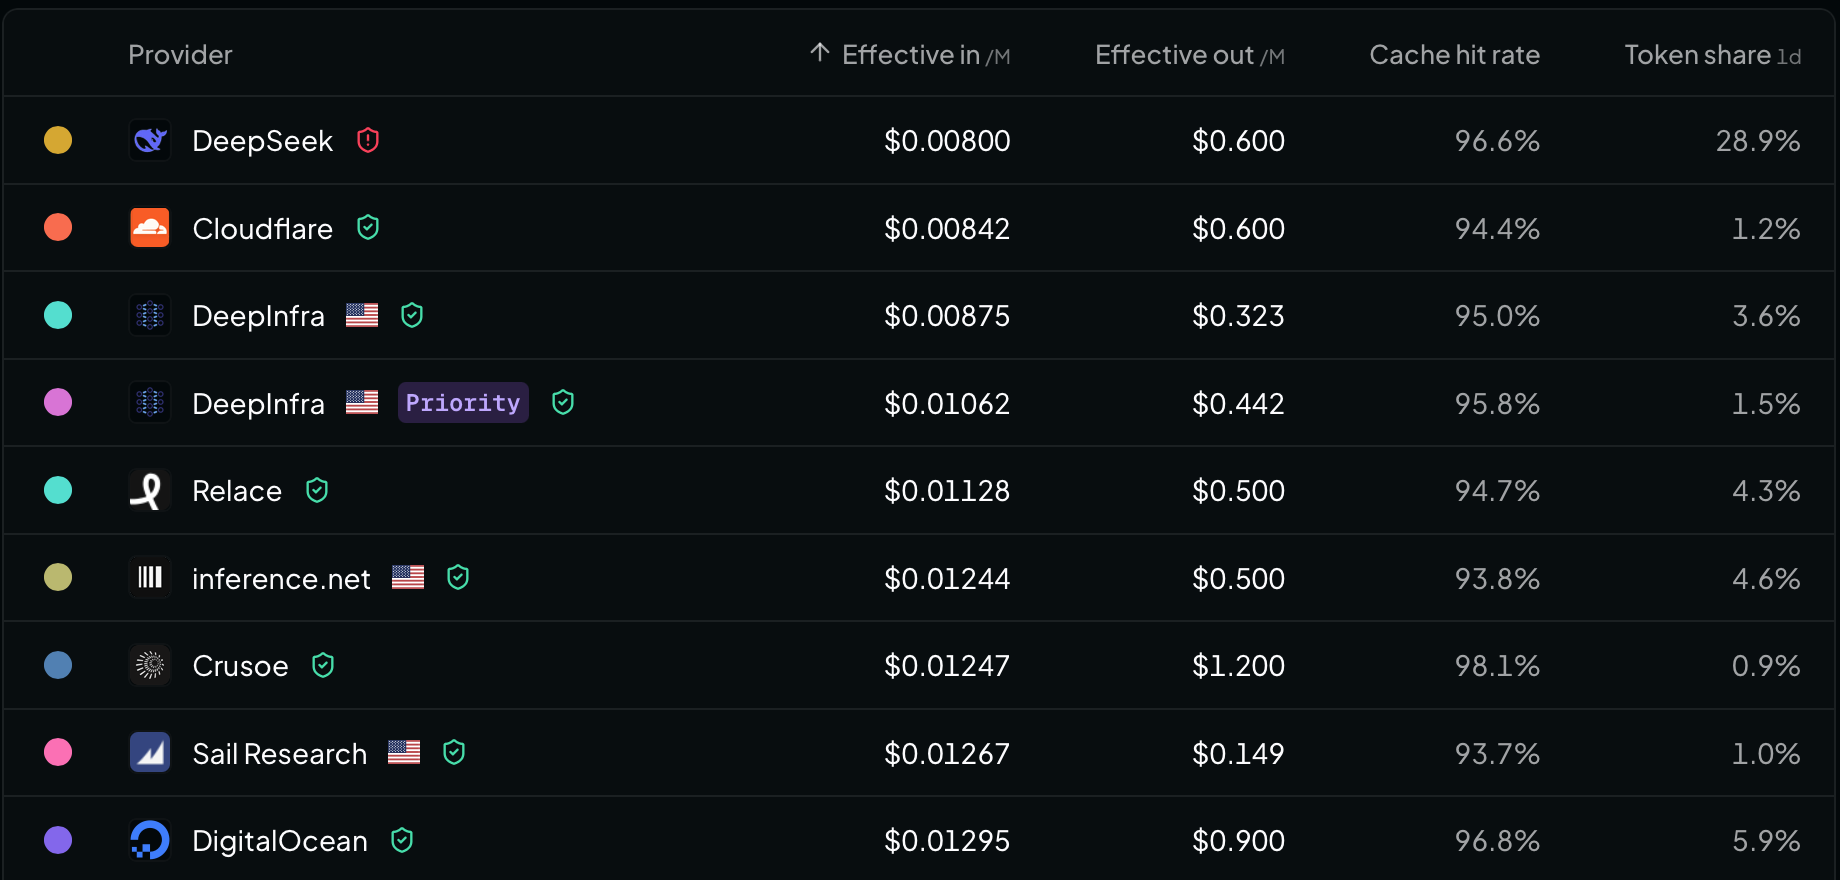
نتیجهای که Woolf میگیرد: آن تئوری معروف «قیمت توکن مصنوعی پایین نگه داشته شده و یک روز گران میشود» با واقعیت جور درنمیآید. OpenAI و Anthropic انحصار ندارند؛ تا وقتی دهها ارائهدهنده میتوانند مدل همکیفیت را با سود سرو کنند، قیمت به سمت هزینهی نهایی میرود.
ولی IPO چه؟
عجیبترین بخش ماجرا زمانبندی است. هر دو شرکت به IPO نزدیکاند و کمکردن درآمد اصلی دقیقاً برعکس چیزی است که روی پرسپکتوس S-1 خوب به نظر میرسد. Woolf مثال خودش را میزند: بعد از ارزانشدن GPT-6.1 Sol، سقف اشتراک Codex خودش را یکپنجم کرد، چون با همان پول ۴ برابر کار درمیآمد. OpenAI هم همزمان سهمیهی پلن ۲۰۰ دلاری Codex را نصف کرد «بهخاطر مدلهای کارآمدتر».
نظر من
به نظرم این مهمترین روند امسال برای ما برنامهنویسهاست و کمتر کسی جدیاش میگیرد. همه دربارهی بنچمارکها بحث میکنند، ولی چیزی که واقعاً تعیین میکند ایجنتها در کار روزمره بمانند یا نه، هزینه است، و آن هم با سرعت دارد سقوط میکند.
دو چیز برایم جالب است. اول اینکه مدلهای open-weight حتی برای کسی که هیچوقت اجرایشان نمیکند هم مفیدند، چون سقف قیمت مدلهای بسته را پایین نگه میدارند. دوم اینکه قیمت روی کاغذ گولزننده است. اگر با ایجنت کار میکنید، فقط به قیمت ورودی و خروجی نگاه نکنید؛ عدد cache read و نرخ cache hit را ببینید، چون اصل خرج همانجاست.
و یک هشدار: ارزانشدن API لزوماً یعنی ارزانشدن اشتراک نیست. همانطور که ماجرای Codex نشان داد، شرکتها راحتتر سهمیهی اشتراک را کم میکنند تا قیمت پایهی مدل را بالا ببرند.
منبع: Max Woolf’s Blog | بحث در Hacker News
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.