Glimpse، اولین مدل Elorian: هوش مصنوعیای که وسط فکر کردن دوباره به تصویر نگاه میکند
استارتاپ Elorian، با مدیرعاملی پژوهشگر سابق DeepMind، مدل Glimpse را عرضه کرد. این مدل حین استدلال روی تصویر و ویدیو زوم میکند و فریم برمیدارد، با چند صد GPU ساخته شده و ۹۴٪ ارزانتر از GPT-6 Astra است.
17 Oct 2026 · 3 min read · هوش مصنوعی · مدل چندوجهی · بینایی ماشین · Elorian · Glimpse · استدلال بصری · رباتیک · استارتاپ
استارتاپ Elorian از پالوآلتو، که قبل از داشتن حتی یک محصول ۵۵ میلیون دلار سرمایهی بذری با ارزشگذاری ۳۰۰ میلیون دلاری گرفته بود، حالا اولین مدلش را منتشر کرده: Glimpse. مدیرعاملش، Andrew Dai، قبلاً پژوهشگر Google DeepMind بوده. ادعای اصلیشان ساده است: مدلهای امروزی با زبان و کد خوب کار میکنند، ولی هنوز واقعاً «نمیبینند».

فرقش با مدلهای چندوجهی معمولی چیست؟
بیشتر مدلهای multimodal تصویر را یک بار نگاه میکنند، آن را به توکن تبدیل میکنند و بعد فقط در متن دربارهاش فکر میکنند. مثل این است که یک عکس را از روی حافظه توصیف کنی. Glimpse در وسط استدلال به خود تصویر برمیگردد. میتواند روی یک ناحیه زوم کند، فریمهای مشخصی از ویدیو را بیرون بکشد، یا کد اجرا کند تا چیزی را اندازه بگیرد و مقایسه کند. Elorian اسم این قابلیت را «visual scratch space» گذاشته است.
این ایده کاملاً تازه نیست، چون OpenAI در ۲۰۲۵ قابلیت crop و zoom حین استدلال را به مدلهای سری o اضافه کرد. حرف Elorian این است که کل مدل را دور همین ایده ساخته و با هزینهی کم. طبق بلاگ رسمی، تیم کوچکشان Glimpse را با فقط چند صد GPU و با پسآموزش (post-training) روی یک مدل پایهی open-weights ساخته است.
قیمت و بنچمارکها
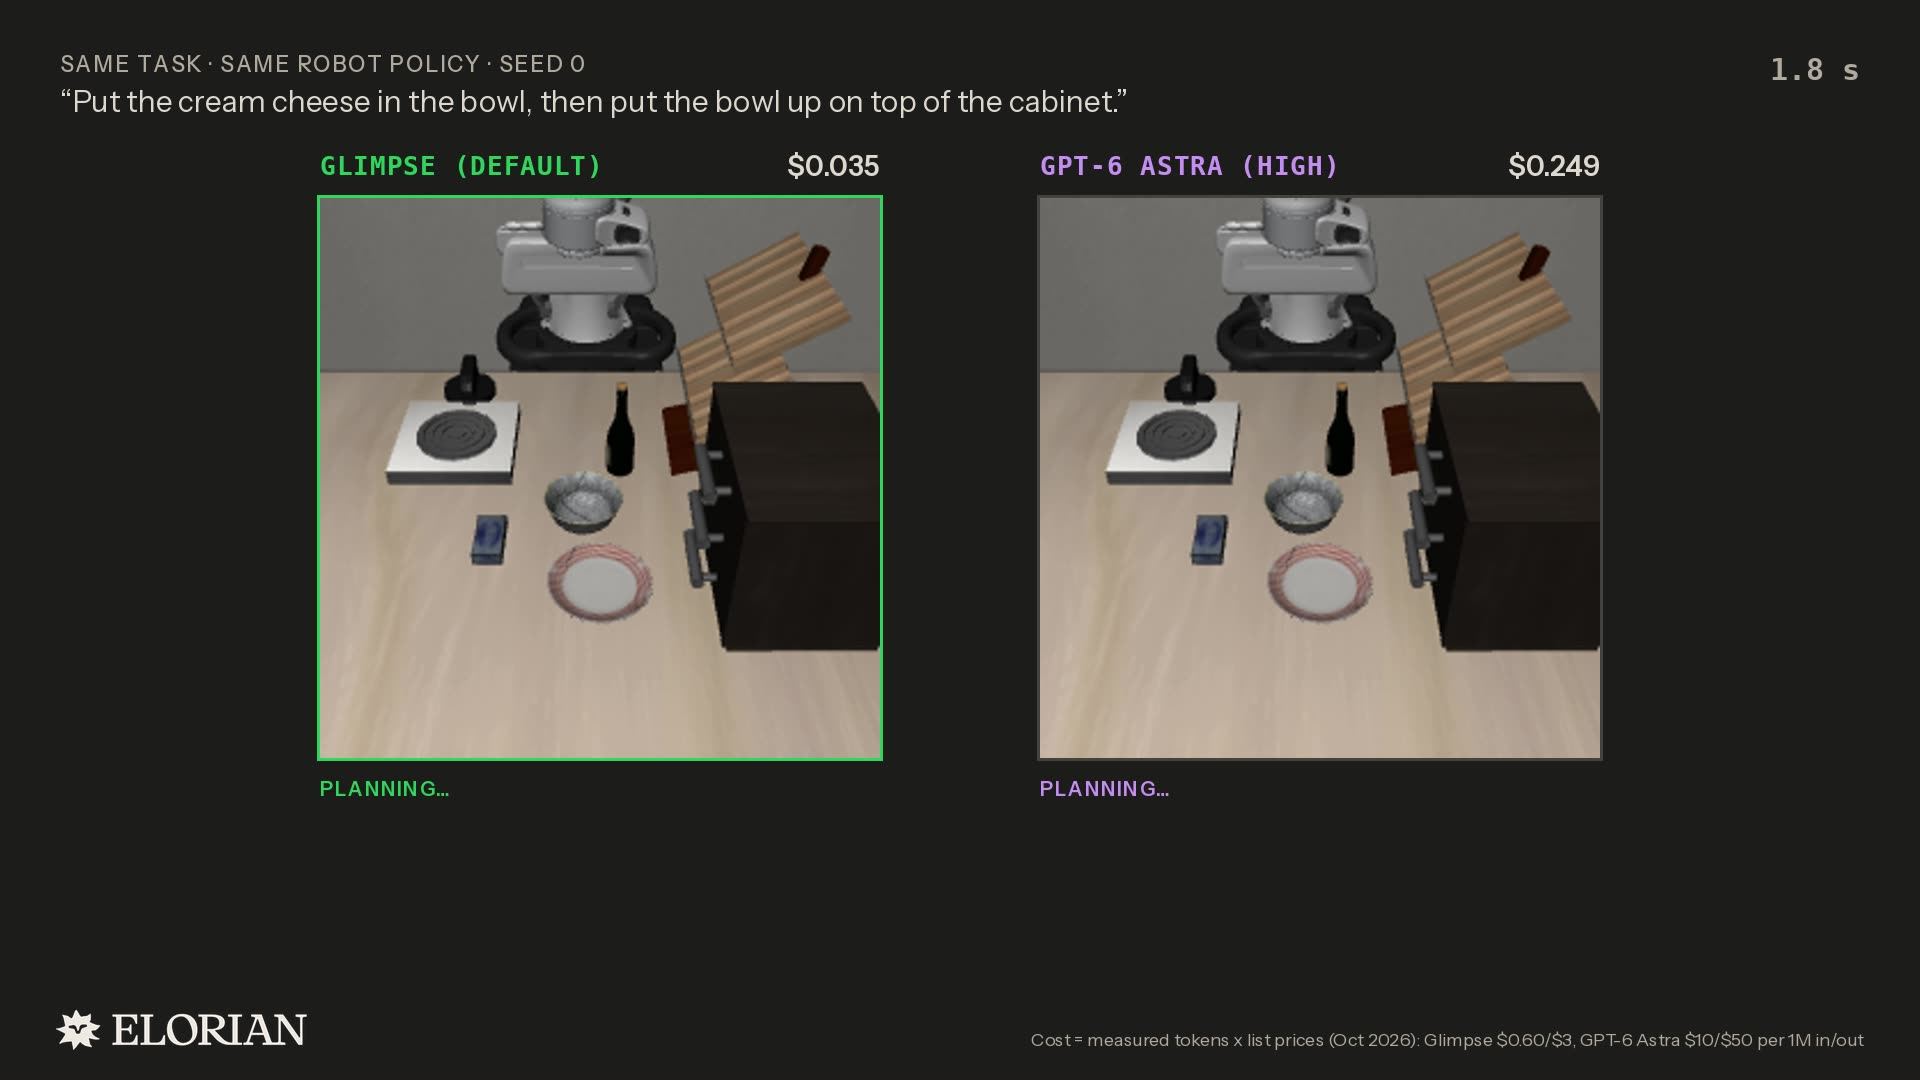
قیمت Glimpse برای هر یک میلیون توکن ۰٫۶۰ دلار ورودی و ۳ دلار خروجی است. به گفتهی Elorian این یعنی ۹۴٪ ارزانتر از GPT-6 Astra، ۸۵٪ ارزانتر از Claude Opus 5.5 و حتی ۲۰٪ ارزانتر از نرخ معرفی Gemini 3.8 Flash.
طبق ارزیابیهای خود Elorian، این مدل در چهار بنچمارک از GPT-6 Astra جلوتر است: استدلال روی نمودارهای علمی (CharXiv-R)، شمارش با واژگان باز (FSC-147)، کپشننویسی ویدیوهای کوتاه (UGC-VideoCap) و فهم رویدادهای دستکاری اشیا در رباتیک (WGO Bench). در ERQA هم با Astra برابر است. ولی در استدلال زمانی دقیق (TOMATO)، کپشن متراکم ویدیو (DREAM-1K) و Video-MME هنوز عقبتر است.
بازار هدف: رباتیک و آرشیوهای ویدیو
مشتریهای اولیه شرکتهایی هستند که حجم زیادی ویدیو دارند: رباتیک، آزمایشگاههای علمی، رسانه و صنایع خلاق. Elorian در بلاگش نشان داده که Glimpse میتواند دادههای teleoperation رباتیک را برچسب بزند و بهعنوان planner برای یک مدل VLA (π0.5 از Physical Intelligence) کار کند. هدف بلندمدتشان رفتن از «دیدن» به «انجام دادن» است، یعنی کنترل مستقیم ربات. Glimpse فعلاً research preview است و از طریق API و رابط چت در دسترس است.
نظر من
به نظرم مهمترین نکتهی این خبر بنچمارکها نیست، چون همهشان را خود Elorian اجرا کرده و تا ارزیابی مستقل نیاید باید با احتیاط نگاهشان کرد. نکتهی مهم این است که یک تیم کوچک با چند صد GPU و یک مدل پایهی باز توانسته در یک حوزهی مشخص با مدلهای فرانتیر رقابت کند. یعنی برای ساختن مدل خوب لزوماً به دهها هزار GPU نیاز نیست. کافی است مسئله را درست انتخاب کنی.
ایدهی «دوباره نگاه کردن» هم به نظرم درست است. هر کس با مدلهای فعلی روی اسکرینشات، نمودار یا نقشهی فنی کار کرده باشد میداند که مدلها اغلب با اعتمادبهنفس چیزی را میگویند که در تصویر نیست. برای ما توسعهدهندهها، مدلی ارزان که ویدیو و تصویر را واقعاً بررسی کند، برای کارهایی مثل QA بصری اپها، تحلیل ویدیوی دوربینها و برچسبگذاری دیتا خیلی بهدرد میخورد. فقط حواستان باشد که «زوم کردن» یعنی توکن بیشتر، و خود Elorian هم قبول دارد که بهرهوری توکن اولویت بعدیاش است. قیمت پایین روی کاغذ لزوماً یعنی صورتحساب پایین نیست.
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.